Attention Sink、归一化约束与显式门控
LLM发展至今,Attention已经成为家喻户晓的词汇(至少对于理工科的学生来说),笔者在通勤途中就能从大一新生口中听到诸如 Attention 、LLM、Infra等热门词汇,其热度可见一斑。然而来到具体的 Attention 内部,我们都知道标准 Softmax Attention 要求每行权重之和为 1。它能分配不同位置的相对权重,但无法在保持比例不变的情况下,把所有权重一起缩小。那么如果一个注意力头只需要很小的更新时,模型应当如何实现?
在查阅一些文章之后,笔者认为这种机制可能和 Attention Sink 有关:模型把较高权重分给某些位,如果这些位置的有效内容贡献很小,就可以在保留其他内容相对比例的同时,缩小整体输出。理解这一关系,需要区分注意力权重、Value 和写入残差流的实际更新。
本博客讨论分为上下两篇,上篇将从 Sink 现象和 Softmax 公式出发,推导它与标量门控的关系,再顺着我们的思路讨论概率单纯形、Sparsemax 和显式门控。由于篇幅原因,对 Softmax₁、Sigmoid Attention、Softpick 及相关实验证据的讨论将在下篇进行。
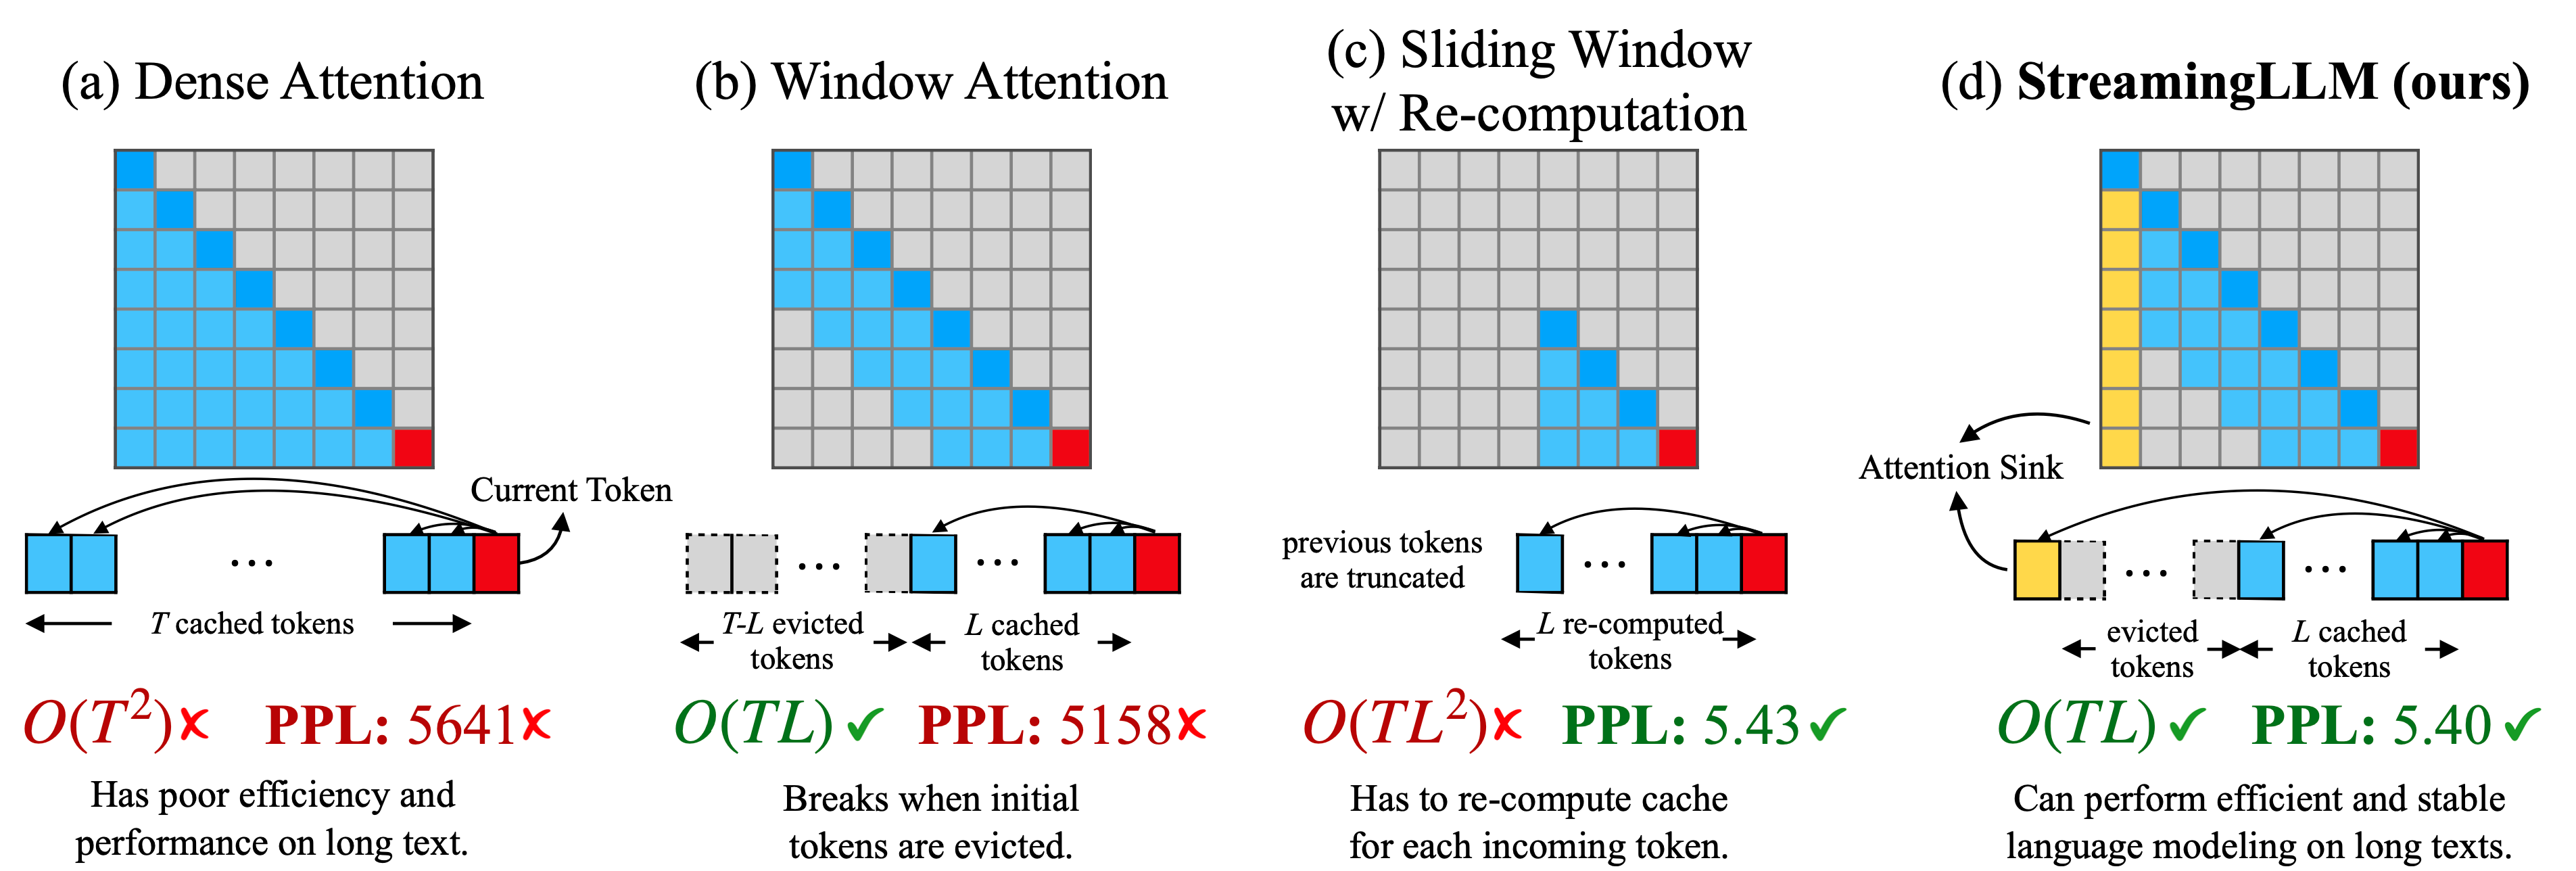
图 1|从左到右:完整注意力、仅保留近期缓存的窗口注意力、重新计算窗口缓存、保留初始 Sink 与近期缓存的 StreamingLLM。黄色表示被保留的初始位置。图片来自 Xiao 等人的官方项目仓库,原图未改动,采用 MIT 许可。图中困惑度及复杂度对应作者的特定实验设置。那么为什么前几个token这么重要呢?

一、Attention Sink:初始位置为什么获得高权重?
1.1 初始位置的高注意力现象
语言模型通常先把文本切成 token,即模型处理文本的基本单位。根据分词方式,一个 token 可以对应词、词的一部分、汉字或标点。
在长文本中,预测通常需要读取相关的人名、变量定义或上下文。
但研究者可视化注意力时发现,一些头会把相当大的权重分给最初几个位置,即使这些位置的字面内容看起来并不重要。
这个现象在 StreamingLLM 中成为一条关键线索:作者发现,直接移除最初位置的缓存,会破坏某些预训练模型的流式生成;留下少量初始位置,再加上最近的一段上下文,可以显著恢复稳定性。该工作于 2023 年公开预印本,发表于 ICLR 2024。[1]
这里的初始位置指序列开头的 token。
Sink 常出现在序列开头,但其数量和位置会随模型、层、注意力头及输入而变化。
1.2 KV Cache 与流式生成
在自回归生成中,模型逐次地预测后续 token。前面位置已经算好的 Key 和 Value 可以存起来,后续复用,这就是 KV Cache。
当序列长度为 ,固定模型宽度、层数和头配置时,完整 KV Cache 的空间开销随 线性增长。一次新 token 对全部历史做注意力,相关读取计算也随历史长度增长;把整个长度为 的密集因果注意力过程加起来,注意力部分通常有二次量级的运算。
只保存最近 个位置可以降低缓存开销,却也会移除模型依赖的初始位置。StreamingLLM 因此同时保留少量初始位置与近期滑动窗口。
这种方法可以维持某些模型的流式生成质量,但无法保存已被删除的全部历史信息,也不等于获得无限长期记忆。[1]
1.3 注意力权重与实际贡献
注意力热力图显示的是权重分布。高权重本身不能说明该位置的内容对最终答案更重要。
注意力输出取决于权重与 Value 的乘积,还会经过输出投影、残差连接和后续网络层。
例如,一个获得 90% 权重的零向量,直接贡献仍然为零;其余 10% 的权重则可能携带决定输出的内容。
删除这个零向量对应的位置后,其余权重会重新归一化,原来 10% 的内容权重可能增至 100%。
因此,直接贡献很小的位置,仍可能通过归一化影响其他位置的贡献。第三章将给出具体推导。
二、Softmax Attention 的归一化约束
2.1 Query、Key、Value 与注意力输出
固定一个注意力头,考虑当前位置 。记它的 Query 为 ,可见历史位置的 Key、Value 分别为 。
- Query:当前位置用于匹配候选的向量。
- Key:候选位置用于与 Query 匹配的向量。
- Value:按注意力权重参与求和的内容向量。
这些向量由模型计算得到,其坐标通常不对应人工指定的语义。
点积注意力先计算匹配分数:
其中 是 Query 和 Key 的维数, 用于控制点积分数的尺度。 是位置 对位置 的原始匹配分数,也称为 logit。
对于允许看到的 个位置,Softmax 把分数转为权重:
为减轻记号负担,后文经常省略当前 Query 的下标 。这是标准缩放点积注意力的单行写法。我们默认关闭 dropout,并在实数运算意义下讨论;被因果掩码禁止的位置不算进这 个候选。[2]
指数函数把实数变成正数,分母再把它们归一化,于是:
2.2 归一化如何控制输出尺度
Softmax 将分数平滑地映射为概率权重,分数较高的候选获得较大权重,输出则是 Value 的加权平均。
如果 ,由三角不等式得到:
固定 Value 的大小后,仅仅增加候选个数,不会让这个平均值的范数按个数无限膨胀。这对训练稳定性很有价值。
归一化提供了竞争机制和输出尺度约束。不过,它也留下一个问题:在保持候选间相对比例的同时,能否独立调节本次读取的整体强度?
2.3 整体降低分数为什么不能减小总权重
假设三个候选的分数都为 ,Softmax 仍然给出:
把三个分数都改成 ,结果不变。
因为 Softmax 对整体平移不敏感:
Softmax 只依赖分数之间的差值,整体分数水平不影响权重。
所以,所有 logits 趋于负无穷并不必然使分布趋于均匀。若它们以相同偏移下降,相对差保持不变,输出分布也保持不变;只有相对差趋于零时,才趋于均匀分布。
例如, 和 给出的权重相同,约为 。降低公共偏移无法减小总权重。
2.4 零权重与零输出的区别
Softmax 不能输出全零的权重向量,但注意力输出可以为零。例如:
Value 之间可以抵消。输出投影也可能把某些方向映到零;不同头的结果还可能进一步相互抵消。
标准 Softmax 权重缺少一个独立的整体缩放变量。 网络可以借助 Value 抵消、输出映射或其他结构实现小更新,但归一化权重本身无法在保持相对比例不变时整体缩小。
三、Sink 何时等价于输出门控?
回到开头的问题:总权重必须分完,但内容未必需要全部写入。如果一个位置接走了部分权重,却几乎不提供有效 Value,留给其他内容的权重就变少了。这正是 Sink 与门控可能相关的地方,下面把这个关系写出来。
3.1 分离 Sink 与内容权重
现在假设在 个内容位置之外,还有一个候选位置 。我们暂且把它叫作 Sink,权重为 。
完整输出是:
只要 ,就能定义两个新量:
由于内容权重的总和是 ,立刻有 。于是原式变为:
这是精确的代数分解: 表示内容总权重, 表示内容位置之间的相对比例。
3.2 零 Value 条件下的精确等价
如果 ,那么:
这就是标量输出门控: 决定内容分配, 控制整体输出强度。
当 时,;当 接近 1 时,内容输出就接近关闭。
不过真实模型的 未必是零。若 ,则:
忽略 Sink 内容项所产生的误差,随 增大。
3.3 输出投影后的有效贡献
注意力头通常还要经过输出投影。把某一头对应的线性输出映射记为 ,它对残差流的贡献为:
由式(9)和 的线性性,先得到精确关系 。即使 本身不小,只要 很小,就可以忽略第一项,得到:
近似误差相应由 控制。
因此,分析残差更新时,应检查投影后的 ,而不能只看原始 Value 范数。若输出映射含有偏置,还需单独计入偏置贡献。
Gu 等人的实证研究表明,某些 Sink 的主要作用接近吸收注意力权重的 Key 偏置,其 Value 未必承担相应的语义读取功能。这支持上述解释,但不意味着所有 Sink 的 Value 都严格为零。[3]
3.4 删除 Sink 为什么会放大内容输出
构造一个一维例子:两个内容 Value 分别为 2 和 4,内容内部权重是 。
完整内容平均值为:
假设 Sink Value 为 0,Sink 获得 90% 权重。那么三个位置的完整权重为 ,输出为:
现在移除 Sink,对剩余分数重新做 Softmax。内容的相对比例保持 ,但总权重从 0.1 恢复到 1,输出变成 2.5,整整放大十倍。
删除 Sink 会同时改变归一化分母,使其他内容的总权重增大。
这个例子说明,Sink 的直接内容贡献很小,删除它却仍可能显著改变输出。对现有模型删除缓存,与从头训练具有显式空选项的模型,需要分别检验。
3.5 注意力占比与参数利用率
Sink 获得 90% 的注意力权重,并不意味着 90% 的参数被浪费。
等参数通常被不同位置共享。注意力权重是一次计算中的加权系数,不能据此换算参数利用率。
某个头在当前输入上的输出很小,也不能说明它在其他输入上无用。
判断 Sink 是否带来额外的表示、数值或计算代价,以及显式门控能否降低这些代价,需要消融实验。
四、初始位置的优势及其解释边界
4.1 因果掩码提供了位置优势
在通常的因果注意力中,第 个位置只能读取不晚于自己的位置。若序列长为 ,第 个位置能被多少个 Query 看到?答案是:
第一个位置可以被所有后续 Query 访问,越靠后的位置能被访问的次数越少。这使初始位置更容易被用作跨位置共享的 Sink。
可见性优势不能单独证明训练必然产生 Sink,也不能确定哪个位置成为 Sink。模型参数化、训练数据、损失和位置处理方式都会影响结果。[3]
4.2 梯度中的位置差异
设 。对一行 Softmax 注意力求导,有:
式(14)由 Softmax 导数 与链式法则得到:,再与上游梯度 作内积即可。其中 在 时为 1,否则为 0。若朝 的方向移动会降低损失,训练就会倾向于提高 。
沿着当前注意力层中“Key 影响分数”的这条直接路径,得到:
这里把 当作当前层的中间变量。若继续追溯到产生它们的共享参数,还要合并其他路径的梯度。
前面的 Key 出现在更多求和项中,意味着它有更多接受训练信号的机会。可是各项会有不同大小和方向,甚至互相抵消。
因此,求和项更多不代表总梯度更大,也不足以证明该位置一定形成 Sink。
4.3 Sink 占比与分数差的关系
设共有 个候选,Sink 分数为 ,其他 个分数都为 0。则:
希望 ,解出:
当 时:
| 希望 Sink 获得的权重 | 所需分数差 |
|---|---|
| 50% | 约 8.318 |
| 90% | 约 10.515 |
| 99% | 约 12.913 |
这些数字只是式(16)的计算结果,不是实测某个模型的 logits。
该例说明:在其余分数相同的条件下,要维持固定占比,分数优势随候选数呈对数增长。它没有说明真实模型的 Key 范数一定按对数增长,因为点积还受 Query、方向、缩放和位置机制影响。
更一般地,记内容分数的 LogSumExp 为:
则 Sink 权重可以改写为:
Sink 占比由 与全部内容分数的 LogSumExp 之差决定,而不只取决于它与第二高分之间的差值。
五、从概率单纯形到次概率单纯形
前面是从一个 Sink 出发做分解。现在换个角度:先不管模型怎样实现,只问权重允许取哪些值。概率单纯形就是“非负且总和为 1”的几何写法;把总和放宽到不超过 1,就能直接表示内容权重一起缩小。
5.1 概率权重的几何约束
先考虑两个候选。由于 且权重非负,合法点从 到 ,组成一条线段。
三个候选时,合法点组成一个三角形面。 共有三个数,但最后一个由前两个决定,所以自由度只有两个。
一般地,概率单纯形定义为:
标准 Softmax 用有限 logits 得到的是这个集合的相对内部:所有允许位置的权重严格为正。这里必须说“相对内部”,因为单纯形嵌在 的一个超平面里;若以整个 维空间为参照,它本身没有通常意义的内部。
这里采用理想实数运算;实际浮点运算可能因下溢产生零权重。
5.2 固定 Value 时的输出集合
所有合法加权平均组成的集合叫作凸包:
两个 Value 的凸包是连接它们的线段,三个不共线的 Value 的凸包是一个三角形区域。
在固定 Value 的前提下,普通概率权重允许的输出位于这个凸包。有限 Softmax logits 通常只访问其中的一部分,边界可以通过极限逼近。
加上 后,允许的输出集合变成:
也就是把原点加进可用的凸组合。
如果原点原本不在凸包里,这确实扩展了输出集合。例如一维 ,原本只能得到 里的数,加门控后就能得到 。
但如果原点本来就在凸包里,例如 ,加入门控并不会扩展这个一维输出集合。它仍可能改变参数化方式和优化难度,但不能再说“表达范围必然增加”。
门控增加了一个控制变量,但是否扩大输出集合,取决于固定 Value 的几何关系。
5.3 允许总权重小于 1
令有效内容权重为 。则:
它们组成:
这称为次概率单纯形,其总质量允许小于 1。
两个候选时,原来的合法集合只有从 到 的斜边;现在连同 ,整块三角形都合法。
和 对两个候选的相对偏好相同,但总读取系数分别为 1 和 0.2。原点 则表示内容权重全为零。
只要 ,下面的分解唯一成立:
因此,非零有效权重可以分解为总质量 与归一化后的条件分配 。
5.4 零权重处的退化与空选项表示
当 时,无论选择什么 ,都有 。因此 与 不是处处一一对应。
当所有有效权重均为零时,条件分配 无法由 唯一确定。
避开原点,就有严格对应:
如果希望包含原点,还能使用另一个全局成立的表示:
右边恰好属于有 个坐标的概率单纯形 ;反过来丢掉第一个坐标,就恢复 。
这说明,允许内容总权重小于等于 1,等价于增加一个坐标,记录剩余质量 。
如果这个额外坐标对应零 Value,那么它就是显式的空选项。前面 Sink 与门控的等价,正好是这条几何事实的计算版本。
上述几何表示相对于 个内容候选增加了一个空选项。真实模型也可以让已有 token 承担这一作用,无需新增 token。
5.5 总质量与输出范数的区别
分解 中, 是权重空间的总质量,并非输出向量的欧氏范数。
因为:
只有固定 时,改变 才是沿同一输出方向缩放。如果 Value 或 也变了,输出方向和长度都会变化。即使 ,Value 抵消仍可能使 。
总质量与条件分配的分解也不意味着两者在欧氏度量下构成正交坐标。
六、Sparsemax:稀疏选择与总质量控制
读到这里,一个自然的疑问是:Softmax 不能把权重全关掉,那换成能产生零权重的 Sparsemax 呢?关键在于,让部分位置为零,与让所有内容的总权重变小,是两回事。 Sparsemax 仍在同一个概率单纯形上选点,因此它与 Sink 的联系,要从这个共同约束来看。
6.1 用投影产生精确零权重
有限分数下,Softmax 会给每个允许位置正权重。若希望无关位置获得严格的零权重,就需要能够产生稀疏输出的映射。
Sparsemax 正是能够产生严格零权重的一类映射。Martins 与 Astudillo 在 ICML 2016 提出它,将分数向量投影到概率单纯形上。[4]
定义为:
也就是在所有非负、总和为 1 的权重向量中,寻找与原分数向量欧氏距离最近的一个。
Sparsemax 允许部分候选的权重为零,但总权重仍然等于 1。
它可以减少参与求和的位置,却无法产生全零权重。稀疏性与总质量是两个不同的约束。
6.2 阈值公式的推导
Sparsemax 的结果可以写成:
其中阈值 被选到满足:
所有分数减去同一个阈值后,将负值截为零;阈值由总权重为 1 的条件确定。
为什么是这个形式?对式(27)加上总和约束和非负约束,其拉格朗日函数为:
驻点条件给出 。当 时,互补条件要求 ,所以 ;当这一结果为负,非负约束就把它截在零。
结合两种情况,即得到式(28)。
6.3 相同分数下的权重比较
沿用前面的例子: 个候选,某个特殊候选分数为 ,其余都是 0。现在假设 。
这时所有候选都还在支持集里,有:
于是:
取 :
| 映射 | 特殊候选的权重 |
|---|---|
| Softmax | 约 0.000402,即 0.0402% |
| Sparsemax | 约 0.500122,即 50.0122% |
当 时,Sparsemax 将全部权重分给特殊候选,其余位置的权重均为零。
更一般地,单位尺度下:
其中 表示只在第 个坐标为 1 的向量。
如果该候选是 Sink,它会获得全部权重。若它的有效 Value 恰好为零,内容输出也随之关闭:此时仍是在利用空选项,不能把它归因于“稀疏就能少分配总权重”。不过,这个固定分数算例无法预测训练后的两类模型谁会出现更多 Sink。
原因首先是两者对分数尺度的要求不同。若用 ,集中到顶点的分数差阈值就变成 。同一个未经校准的 ,不一定代表两种训练系统里公平匹配的条件。
此外,两类模型会学到不同的 Query、Key 和 Value。该算例能直接说明的是:Sparsemax 可用有限分数差达到单纯形顶点,但仍无法产生总权重为零的结果。
6.4 精确稀疏与局部零梯度
定义支持集 ,大小为 。在支持集不变化的区域,Sparsemax 的 Jacobian 为:
这里 在 时为 1,否则为 0。
如果支持集中只有一个位置,即 ,在严格位于该区域内部时,整个 Jacobian 为零。对于当前样本和当前路由,损失难以通过这条分数梯度路径,把它从“只看一个位置”中拉出来。
相关参数仍可通过其他样本、位置或共享计算路径更新;支持集边界处还需考虑不可微性。这里的结论只针对当前支持集内部的局部梯度。
Softmax 接近 one-hot 时同样可能梯度很小;区别是,在有限实数 logits 下它通常是渐近饱和,Sparsemax 可以在一个有限区域中精确变平。
6.5 抑制低分干扰项与结合门控
假设 Sparsemax 已经确定阈值 ,某些候选的分数低于它。若新增候选的分数也不高于这个阈值,旧输出附上若干零之后,仍然满足相同的投影条件。
在此条件下,增加低分干扰项不会改变已有权重。
Softmax 则不同:每个有限分数的新增候选都会给分母增加正值。单个干扰项很小,数量足够多时,总量仍可能可观。
这一性质以 logits 固定为前提。真实网络加入新 token 后,表示、位置编码和 Query 都可能变化,因此不能直接据此推断长上下文检索能力。
Peters 等人后来提出的 -Entmax 家族,把 Softmax 和 Sparsemax 放进同一类正则化预测映射中,并提供稀疏输出的中间选择。它也仍然在概率单纯形上分配质量。[5]
因此,一个自然的组合是:
这样的组合分别控制参与读取的位置与整体输出强度,其实际收益需要通过训练实验检验。
七、Softmax 与单纯形的对应关系
前面使用单纯形描述注意力权重。还剩一个问题:Softmax 和 Sparsemax 都在这个集合上分配权重,差别究竟在哪里?下面从 logits 和优化目标两方面说明它们怎样选点,也解释为什么“换一种分配方式”不等于“放宽总和为 1 的约束”。
单行自由 logits 去掉整体平移后,与单纯形的相对内部一一对应。 这一结论依赖于 logits 可以自由取值,不能直接推广到整个 Transformer。
7.1 去除整体平移自由度
由式(5), 与 产生相同权重。因此 个 logits 中有一个整体平移自由度不影响结果。
最方便的做法,是规定所有 logits 的和为零。这个规定不会损失表达能力,因为任意 都能减去自己的均值。
给定一个所有分量严格为正的概率向量 ,定义:
它的总和为零,重新做 Softmax 又恰好得到 。这给出了显式逆映射。
用稍正式的语言:
式中的商空间将相差一个整体常数的 logits 视为同一类,从而去掉不影响权重的冗余自由度。
另一种坐标更直观:把最后一个 logit 定为零,其余为 。这就是相对于参考候选的对数比值。
7.2 有限分数与单纯形边界
任意两个候选都有:
当 而 保持为正,右边趋于正无穷。于是,在去掉整体平移后,逼近单纯形边界需要相应的 logit 差不断增大。
这解释了 Softmax 精确 one-hot 在有限实数 logits 下不可达,而 Sparsemax 可以通过有限区域映到边界。
较大的 logit 差本身不能确定隐藏层是否存在异常大激活。分数差可能来自不同因素,而绝对 logits 很大也可能只包含一个不影响权重的公共偏移。
7.3 熵正则化下的优化解释
定义熵:
在单纯形上,下面的优化问题有 Softmax 作为解:
第一项鼓励把质量交给高分候选,第二项鼓励不要过早把分配压得过于尖锐。用拉格朗日乘子求导,得到 ,归一化后就是原公式。
Sparsemax 则等价于:
两式使用不同的正则项选择权重,但约束集合相同,都要求 。
因此,替换正则项会改变分配方式;放宽总质量约束则改变可选权重的集合。
从凸分析看,。LogSumExp 的凸共轭在单纯形上为 (约定 ),在单纯形之外为正无穷。
7.4 这一对应为何不能推广到整个 Transformer
只知道 ,并不知道 ,因此不知道输出 。而且同样的点积矩阵也可能由不同的 Query、Key 分解得到。
在不额外加入约束的纯点积表示里,对任意可逆矩阵 :
这个例子说明,同一个注意力权重矩阵可能对应不同的 Query、Key 表示。具体架构中的位置编码和归一化,会限制可实现的参数变换。
更进一步,一个头的多行 logits 来自共享的 ,不等于每一行都拥有独立自由分数。对未加掩码的点积矩阵,有 。
然而,经过逐行 Softmax 和因果掩码后,不能继续声称注意力矩阵的秩也至多为 。特别是允许自注意、对角线严格为正的因果注意力矩阵是下三角矩阵,在精确算术下可以满秩。
苏剑林在《注意力机制真的可以“集中注意力”吗?》中讨论了将低秩论证用于因果 Attention 时的困难,并进一步分析注意力的集中程度。[6]
因此,单纯形描述的是注意力权重的取值空间,不能完整表示 Transformer 的参数与计算。
八、显式门控的作用与限制
至此可以把两件事分开了:Softmax 或 Sparsemax 决定内容之间怎样分配,标量门控决定这份内容整体写入多少。Sink 在有效 Value 很小时能间接承担后一项,但其强度受 Sink 与内容分数的竞争影响;显式门控则为它单独设置一个变量。
8.1 用标量控制残差更新
考虑一个简化残差模块:
增加一个输入相关门控后:
负责产生候选更新, 负责控制它的强度。若 是一个 128 维向量,一个标量就能同时缩放这 128 个分量。
原模块也可能学会在部分输入上输出零。显式门控提供了直接调节幅度的路径;是否更容易训练或更节省成本,仍取决于具体任务。
8.2 一个最小二乘例子
假设当前希望得到的理想更新是 ,模块已有输出为 。暂时固定它们,只允许调节门控,优化:
若 ,求导并考虑区间约束可得:
若 ,目标与 无关,任意门控都一样。
假如 ,最优 ,方向不必重学,调小幅度就够了。假如 ,候选更新在目标方向上没有正贡献,最优选择是 。
标量门控因此可以保留、缩小或抑制一个已有更新。
不过,标量缩放无法修正错误的方向,也无法补充 中缺失的信息。
8.3 门控梯度与饱和
令 ,,上游梯度为 。则:
若 ,增强输出会增加损失,梯度下降会倾向于降低 和 ;反之则会倾向于增大它们。
当 sigmoid 接近 0 或 1 时,因子 趋近于零,门控梯度也会减小。
同时,如果内容分配仍为 Softmax,固定 Value 时:
当 很小时,内容分配的梯度也被缩小,可能使这一分支过早停止有效学习。
因此,门控的初始化、偏置、学习率和训练长度仍需合理设置。
8.4 输入相关门控的残差 Jacobian
对于式(40),当 依赖 时,完整 Jacobian 为:
常见的简化式 ,只在把 当作对 的常数,或明确忽略门控依赖路径时成立。
当 与 都较小时,模块的 Jacobian 接近恒等矩阵。仅有 小不足以保证这一点,还需考虑 、 和门控导数的大小。
8.5 标量门控与逐通道门控
前面讨论的是标量 ,即一个头的所有输出通道一起缩放。但实际研究还会使用向量门控:
其中 表示逐分量相乘,各通道可以使用不同的缩放系数。
向量门控可能改变输出方向,通常不能合并成一组对所有 Value 通道共同适用的标量权重 。例如原输出 ,门控为 ,结果是 ;不存在一个标量 能把 缩放成 。
因此,“门控注意力属于次概率单纯形”需要限定:对于整体标量门控,可以在 token 权重层面这么解释;逐通道门控一般更丰富。
Qiu 等人的 NeurIPS 2025 工作比较了多种门控位置与形式,包括按头标量和逐元素门控。其中表现最好的配置在缩放点积注意力(SDPA)输出上使用区分不同头的逐元素 sigmoid 门控。因此,论文结果需要结合其具体门控形式理解。[7]
8.6 输出关闭与计算节省
若实现先完整计算 Attention,再乘上接近零的门控,就不会省去已经完成的注意力计算。
输出稀疏、权重稀疏、硬件实际跳过计算,是三个层次。
要获得速度收益,通常还需要提前路由、适合硬件的块结构、稀疏内核或编译支持。
九、小结
这篇文章从一个简单的问题出发:Softmax Attention 的权重为什么一定要加起来等于 1? 归一化让注意力变成候选之间的相对分配,因此无法在保持相对比例不变的同时,把所有内容权重一起缩小。Attention Sink 提供了一种可能的间接实现:如果某个位置吸收了大量权重,却几乎不向残差流提供有效内容,那么它就相当于替其余内容加上了一个标量门控。
沿着这个思路,概率单纯形与次概率单纯形给出了更直接的解释:标准 Attention 解决的是“读哪里”,而允许总质量小于 1,或者显式加入门控,则进一步解决“这次读多少、写多少”。Sparsemax 虽然可以让部分位置精确为零,但总权重仍然是 1,因此“稀疏选择”和“整体缩小”是两个不同的问题。
目前在我们的推导下,能得到的结论不是Softmax 的归一化不好,也不是 Sink 一定意味着设计缺陷。更准确地说,总和为 1 既是约束,也是有用的工具,它带来了竞争、归一化和输出尺度控制。Softmax未必是最优的设计方式,总和也未必要等于1,或许仍有一些的迭代空间。
参考文献
[1] Xiao, G., Tian, Y., Chen, B., Han, S., & Lewis, M. Efficient Streaming Language Models with Attention Sinks. ICLR, 2024. 论文;官方项目与 FAQ。
[2] Vaswani, A., Shazeer, N., Parmar, N., et al. Attention Is All You Need. NeurIPS, 2017. 论文。
[3] Gu, X., Pang, T., Du, C., Liu, Q., Zhang, F., Du, C., Wang, Y., & Lin, M. When Attention Sink Emerges in Language Models: An Empirical View. ICLR, 2025. 正式论文页面;预印本。
[4] Martins, A. F. T., & Astudillo, R. F. From Softmax to Sparsemax: A Sparse Model of Attention and Multi-Label Classification. ICML, 2016, PMLR 48:1614–1623. 正式论文与全文。
[5] Peters, B., Niculae, V., & Martins, A. F. T. Sparse Sequence-to-Sequence Models. ACL, 2019. 正式论文。
[6] 苏剑林。注意力机制真的可以“集中注意力”吗? 科学空间,2023 年 12 月 12 日。 原文。
[7] Qiu, Z., Wang, Z., Zheng, B., et al. Gated Attention for Large Language Models: Non-linearity, Sparsity, and Attention-Sink-Free. NeurIPS, 2025. 正式论文页面;论文全文。
图片来源
配图与许可文本随本文一同提供。
- 图 1:StreamingLLM 官方仓库
figures/schemes.png,MIT 许可;完整许可文本见 MIT 许可文本。图中的 “ours” 指原论文作者的方法。